Un agent IA corrige un bug en quelques secondes, mais souvent à côté de sa cause, et la CI repasse au rouge un peu plus loin. Dans cet article, je raconte, commits à l’appui, comment ses erreurs répétées sur un projet perso sont devenues un standard Lean. Vous y trouverez la méthode, les vrais chiffres, et le standard à reprendre chez vous.
Pas l’temps de tout lire !
- Chaque fois que l’agent IA se plante, je me demande ce qui manquait dans mes consignes, et je l’ajoute.
- Au début, j’ai laissé l’agent remplir un fichier de consignes avec ses apprentissages : trop long pour lui, illisible pour moi. Ma formation Lean m’a ramené au standard : une intention, des erreurs types, des points clés vérifiables.
- Mes commits le montrent : 9 corrections d’affilée pour un premier déploiement, et la même correction à refaire 6 minutes plus tard dans d’autres fichiers.
- Un agent IA, c’est un débutant qui sort de l’école : un bagage technique avancé, mais pas la réalité du terrain. Le former, c’est tester sa capacité à transmettre.
L’agent corrige vite, mais à côté de la cause
Dans un article précédent, j’ai testé GitHub Copilot pour développer une web app en JS : la carte des chemins de randonnée autour de ma commune, pour les membres de mon association. C’était un projet perso, pour évaluer ce que l’IA savait faire et faire évoluer mes propres compétences. J’y tenais tous les rôles à la fois, lead dev, PM et client final, avec une question : peut-on réduire le lead time sans perdre en qualité ?
J’en tirais déjà quelques leçons. Par défaut, Copilot ne proposait ni tests ni documentation, et c’est moi qui les avais demandés. Une fois en place, il continuait de les proposer à chaque évolution : j’en concluais qu’il apprenait de mes pratiques. Dans cet article, je vais plus loin, sur la façon d’apprendre à un agent IA à travailler avec mes standards.
En laissant l’agent proposer les nouvelles fonctionnalités et les corrections, j’ai vu le même scénario revenir. L’agent voit un message d’erreur, il trouve le fichier en cause, il le corrige. Puis ça plante ailleurs.
L’agent a toute la connaissance du monde dans son entraînement et accès à tout le code du projet. Je m’attendais à ce qu’il propose des corrections durables : dépendances entre fichiers, tests, documentation. C’était ma « misconception ». Ces pratiques, qui sont pour moi le minimum en développement, il fallait les lui apprendre.
Ce que racontent mes commits
« Sans data, vous n’êtes qu’une personne de plus avec une opinion », disait W. Edwards Deming. C’est ma devise : j’ai été chercheur, puis data scientist, et je préfère décider sur des faits. Alors j’ai relu l’historique git du projet, qui est public.
- Le 9 décembre 2024, le premier déploiement prend 9 commits « Fix… » en deux heures. Chacun corrige l’erreur suivante de la CI : un module manquant, la configuration webpack, une permission, la version de Node.
- La version de Node passe de 14 à 16 pour accepter un seul opérateur (
??=), puis à 18 quatre jours plus tard, puis à 22 un an après, quand la version requise est enfin déclarée danspackage.json. Trois rustines avant de traiter la cause. - Le 10 août 2025, une mise à jour de
googleapiscasse la CI. La première proposition de l’agent : revenir à l’ancienne version. Il a fallu que je demande « N’est-il pas plus sûr de passer à la nouvelle version ? », puis deux fois « D’autres fichiers ont-ils besoin de la même correction ? ». La correction est arrivée en deux commits, à 19:02 puis à 19:08.
Aucune de ces corrections n’est fausse. Elles traitent le symptôme visible, une à la fois.
Vingt minutes pour passer de mes questions à un guide
Cinq minutes après ce dernier commit, à 19:13, j’ai demandé à Copilot (en anglais) : « Comment te donner des consignes à appliquer à chaque échange ? Par exemple : as-tu vérifié que d’autres fichiers ont le même problème ? Tu as ajouté du code, est-il testé ? Tu as ajouté une étape à la procédure, est-elle documentée ? »
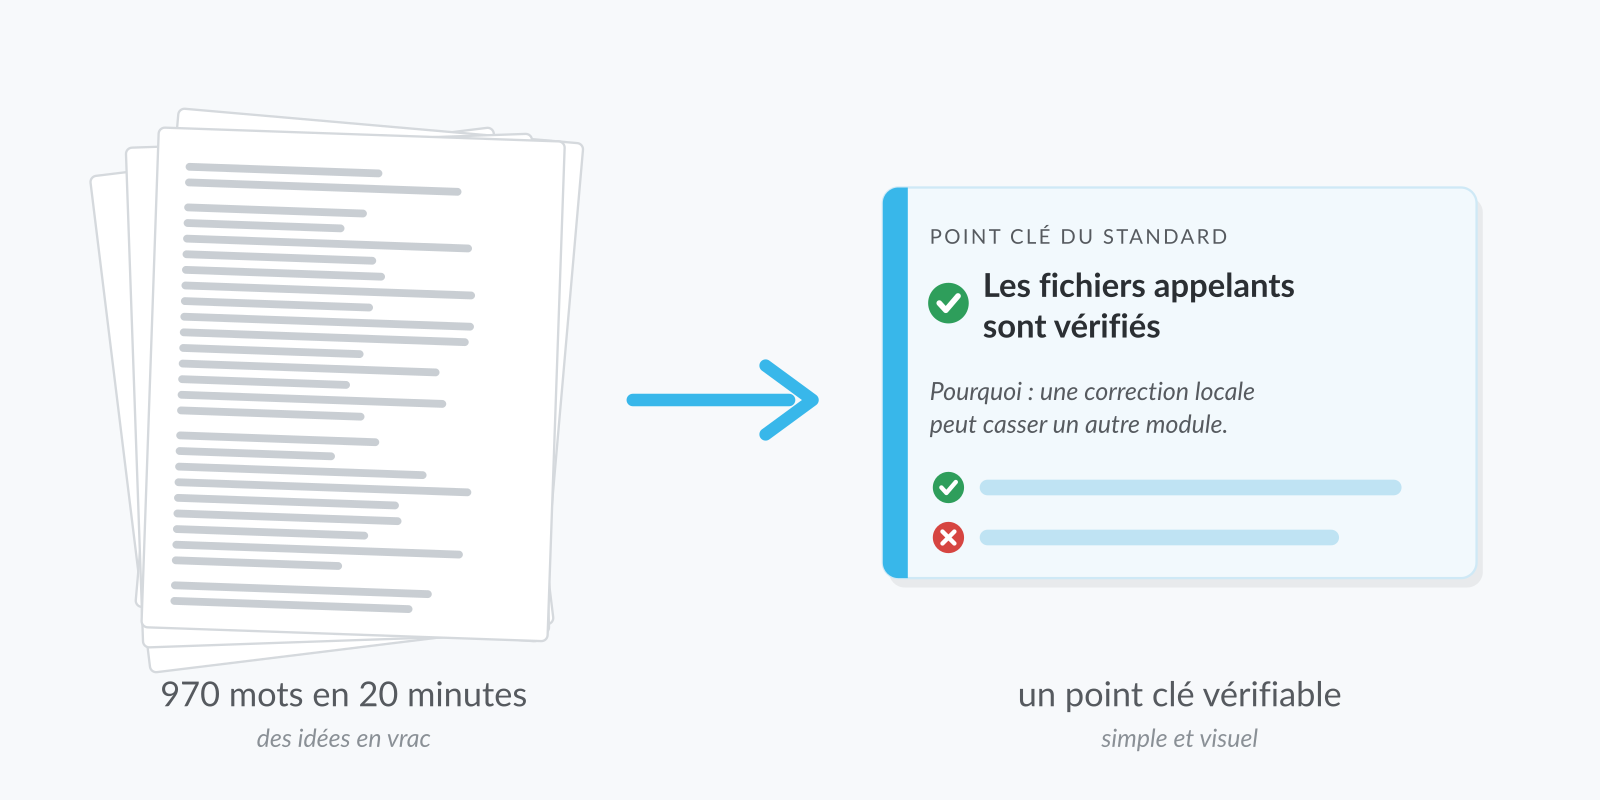
En vingt minutes et sept demandes, le guide est passé de 172 à 970 mots. Deux demandes venaient directement d’erreurs répétées :
- « Dans ce projet, on oublie toujours de mettre à jour les dépendances avant le commit. »
- « Après une série de questions et de corrections, tu ne proposes pas de nettoyer le dépôt. »
La dernière disait tout de mon intention : je voulais que « Suis notre guide » soit la seule phrase à taper, et que l’agent fasse le reste.
Au fond, je disais à l’agent : « remplis ce fichier de tes apprentissages ». Chaque erreur ajoutait un paragraphe, et le guide se remplissait d’idées en vrac.
Un débutant n’apprend pas avec un guide de 200 pages
Au bout d’un moment, j’ai vu que ce n’était pas efficace, pour deux raisons. Un fichier trop long, l’agent en perd une partie en route : même avec des fenêtres de contexte de plus en plus grandes, il ne prend plus tout en compte au fil du temps. Et un fichier rempli par l’agent est illisible pour un humain : personne ne le relit, donc personne ne le corrige.
C’est la vidéo de Régis Médina, « 9 lies about AI », qui me l’a rappelé. Régis y explique comment entraîner une IA avec un standard Lean écrit en langage naturel, pour que ses propositions intègrent les bonnes pratiques que vous avez déjà. Au travail, j’ai ce réflexe : observer le terrain, écrire la bonne pratique, boucler l’amélioration continue. Sur mon projet perso, je l’avais oublié, et ma formation Lean est réapparue.
On ne fait pas lire un guide de 200 pages à un débutant en espérant qu’il intègre tout, et encore moins qu’il monte en compétences. Ce qui marche, c’est un standard Lean : simple, visuel, qui donne l’intention plutôt que le « comment », avec plusieurs niveaux de lecture selon l’expérience. Les titres suffisent. Les exemples aident quand on a un doute, avant d’appeler à l’aide.
Mon guide n’était qu’une liste de questions : ce que l’IA devait faire, jamais ce qui était raté. Or un standard dit les deux, pour qu’on sache si un travail est OK ou pas OK. Il a donc changé de forme :
- août 2025 : une liste de questions à se poser ;
- mars 2026 : une procédure en étapes pour l’analyse d’un défaut ;
- avril 2026 : deux standards, l’analyse d’un défaut et la modification du code, avec une intention, des erreurs types et des points clés ;
- novembre 2026 : chaque point clé est vérifiable, avec son pourquoi et des exemples ✅ / ❌.
Voici un point clé tel qu’il est aujourd’hui :
Point clé du standard
✅ Les fichiers qui appellent le code modifié sont listés, et leur compatibilité est vérifiée
Une correction locale peut casser un autre module qui dépendait de l’ancien comportement.
- ✅ «
getUser()est appelée dansprofile.jsetadmin.js: les deux gèrent le nouveau retournull. » - ❌ La CI échoue après la correction parce qu’un autre module dépendait du code modifié.
Les niveaux de lecture sont là : le titre en gras suffit à qui connaît déjà le geste, le pourquoi en italique aide à l’appliquer à un cas nouveau, et les exemples tranchent quand on doute.
Le standard vit aussi de ses propres erreurs. En mai 2026, la règle « toujours lancer npm update avant de commiter » faisait bouger des dépendances sans rapport, alors qu’il n’y avait qu’une faille à corriger. Le guide dit désormais d’utiliser npm install --package-lock-only dans ce cas. La règle n’a pas été effacée : elle a été précisée, et le changement est daté.
L’IA se comporte comme un junior, et ça parle de mon équipe
Le soir même, le guide tout juste écrit demandait de documenter toute nouvelle procédure. L’agent ne m’a pas proposé de citer le guide dans le README. À 19:47, je lui ai demandé pourquoi. Sa réponse : « J’ai manqué de suivre le guide, alors qu’il était dans le dépôt. C’est exactement la situation qu’il devait éviter. Je ne pense pas qu’il faille modifier le guide. » Ce n’était pas la dernière fois : « C’était écrit que je devais faire cette opération, mais je n’ai juste pas suivi le standard cette fois-ci. »
Marrant, c’est pareil avec les humains. On a beau avoir un super guide de bonnes pratiques, tout le monde ne le suit pas toujours. Et là, en tant que manager ou coach, la bonne question n’est pas « pourquoi tu t’es trompé ? » mais « pourquoi tu n’as pas suivi le standard ? ». On croit déjà le connaître, il est trop compliqué, il n’est pas au bon endroit, on n’a pas le temps… Chaque raison est une piste d’amélioration du standard, pas un reproche.
Si même une machine programmée pour suivre des instructions a envie d’aller trop vite, alors un humain ! Si mon standard n’est pas clair, accessible, facile à intégrer, mon agent IA se plantera, et mes collègues aussi.
Je n’avais pas d’équipe sur ce projet, mais tout ça me rappelait ce que je vivais en équipe sur de vrais projets. Un agent IA, c’est un débutant qui sort de l’école avec un bagage technique avancé, mais sans la réalité du terrain. Ce qui lui manque, je peux le lui transmettre, grâce à mes principes Lean. Développeur, responsable de production puis PM, j’en ai gardé une conviction : la tech n’a de valeur que par son impact sur les utilisateurs et sur les collaborateurs, et c’est sur l’humain qu’il faut mettre l’énergie.
Écrire pour l’IA m’a obligé à creuser dans ma tête pour mettre sur papier ce que je sais que je fais bien quand je développe. Je découvrais le JavaScript, mais pas la démarche : la recherche de la cause racine, je l’avais apprise en R. Tester le standard sur un agent, c’était tester ma capacité à transmettre. C’est aussi ce qui m’a permis de proposer, dans mon poste actuel, un fonctionnement plus abouti avec des agents IA : ce sera l’objet d’un prochain article.
Ce qui a changé avec les agents d’aujourd’hui
En 2025, il fallait rappeler à l’agent de relire le guide avant chaque réponse. Aujourd’hui, les agents lisent d’eux-mêmes un fichier d’instructions à la racine du projet (AGENTS.md, CLAUDE.md). Raison de plus pour le garder court et lisible : il est chargé à chaque session. Un hook de pre-commit peut bloquer ce qui ne doit pas passer. Le dépôt de ce blog en a un, qui refuse toute modification d’un ancien article.
Ils ne vont pas pour autant chercher la cause d’eux-mêmes. De juin à septembre 2026, la CI de la carte cassait sans arrêt. Du 20 juillet au 26 septembre, aucune release hebdomadaire n’est sortie, pendant 68 jours, alors que 25 mises à jour de dépendances avaient été fusionnées. En creusant avec Claude Code, j’ai trouvé deux causes. L’audit de sécurité bloquait le déploiement à cause de failles dans des dépendances de développement, qui n’arrivent jamais en production. Et la fusion automatique pouvait passer sans attendre la CI. La correction durable n’a pas été d’ignorer l’audit, mais de ne bloquer que les failles graves des dépendances de production, et d’obliger chaque fusion à attendre une CI verte.
De cette session, il ne me reste qu’un fichier de mémoire écrit par l’agent. Il a la forme d’un point de standard : la décision, son pourquoi, et comment l’appliquer : « ne pas réintroduire un audit complet bloquant, ni des fusions qui contournent les vérifications ».
Le standard ne sert plus à apprendre à l’agent à lire ses consignes. Il sert à transmettre un regard : le mien, qui cherche la cause avant de corriger.
Le standard, à reprendre chez vous
Mes deux standards sont disponibles sur mon dépôt GitHub blog_tips : l’analyse d’un défaut technique et les modifications du code. Ils sont écrits pour des humains comme pour des agents IA.
Pour commencer le vôtre, pas besoin de tout écrire d’un coup :
- Choisissez un geste que vous répétez souvent : analyser un bug, relire une modification.
- Écrivez son intention et trois points clés que l’on peut vérifier par oui ou non.
- À chaque erreur, de l’agent ou d’un collègue, posez deux questions : « qu’est-ce qui manquait dans le standard ? » et « qu’est-ce qui aurait permis de le voir plus tôt ? ».
Et vous, quelle est la consigne que vous répétez le plus souvent, à une IA ou à un collègue ? C’est peut-être le premier point clé de votre standard. Dites-le-moi en commentaire !